تا حالا به این فکر کردهاید که محتوای سایتتان میتواند هم در نتایج گوگل دیده و هم برای آموزش هوش مصنوعی استفاده شود؟ شاید بخواهید گوگل مقالههایتان را به کاربران نشان دهد، اما اجازه ندهید همان محتوا برای آموزش مدلهای هوش مصنوعی به کار برود. تا امروز، مدیریت این موضوع چندان ساده نبود، چون هر شرکت هوش مصنوعی روش خودش را برای اعلام ترجیحات ناشران داشت. اما حالا گوگل با پیشنهاد یک دستور جدید در فایل robots.txt، بهدنبال سادهتر کردن این ماجرا است. اما این دستور دقیقا چه کاری انجام میدهد؟ در این محتوا با ما همراه باشید تا دستور جدید robots.txt برای آموزش هوش مصنوعی را بررسی کنیم.
نکات مهم در یک نگاه
نکات مهم محتوای دستور جدید robots.txt برای آموزش هوش مصنوعی در یک نگاه:
- گوگل قصد دارد از یک دستور مشترک در فایل robots.txt برای اعلام ترجیح سایتها درباره استفاده از محتوایشان در آموزش هوش مصنوعی پشتیبانی کند.
- توکن پیشنهادی این دستور __usage_ai-training است و میتواند برای کل سایت یا مسیرهای مشخص استفاده شود.
- این دستور با Google-Extended و Googlebot تفاوت دارد. نباید آنها را به جای یکدیگر به کار برد.
- گوگل هدفگذاری کرده است که همراه سایر ارائهدهندگان هوش مصنوعی، از این سازوکار در سال ۲۰۲۷ پشتیبانی کند. بنابراین هنوز نباید آن را یک قابلیت کاملا اجرایی و فراگیر در سال جاری در نظر گرفت.
دستور جدید robots.txt چه مشکلی را برای مدیران سایت حل میکند؟
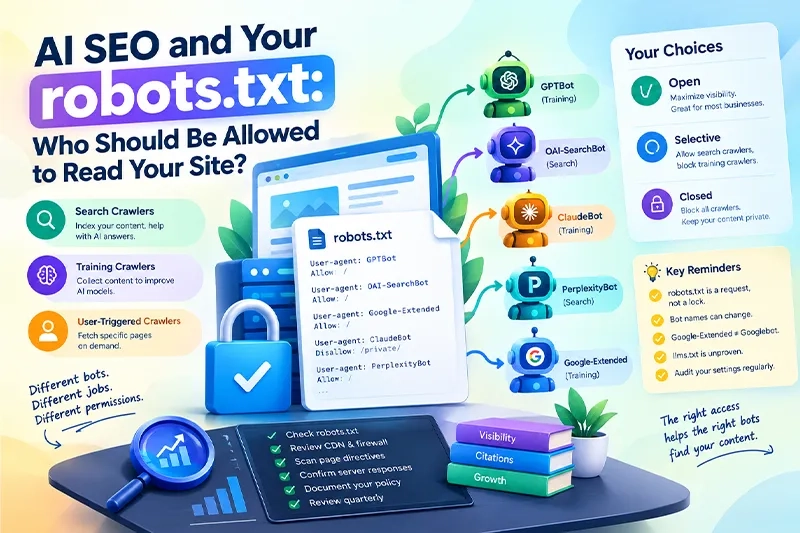
تصور کنید صاحب یک سایت آموزشی هستید و مقالههای شما درباره خدمات سئو، بازاریابی و طراحی سایت در اینترنت منتشر شدهاند. شاید بخواهید گوگل صفحاتتان را برای نمایش در نتایج جستوجو بخواند، اما تمایلی نداشته باشید محتوای همان صفحات برای آموزش مدلهای هوش مصنوعی استفاده شوند. این دو موضوع یکسان نیستند و یکی از مشکلات مدیران سایت، کنترل جداگانه آنها است.
تا قبل از معرفی سازوکار مشترک دستور جدید robots.txt برای آموزش هوش مصنوعی، هر شرکت هوش مصنوعی میتوانست روش اختصاصی خودش را برای دریافت ترجیحات ناشران داشته باشد. در نتیجه، مدیر سایت برای اعلام مخالفت با استفاده از محتوا در آموزش مدلها باید دستورالعملهای مختلف شرکتها را بررسی میکرد. اگر چندین ارائهدهنده هوش مصنوعی از سایت بازدید کنند، مدیریت این تنظیمات بسیار پیچیده و زمانبر میشود. به همین دلیل آشنایی با روش تنظیم robots.txt برای هوش مصنوعی به مدیران سایت کمک میکند تا کنترل دقیقتری بر نحوه استفاده از محتوای خود توسط شرکتهای فعال در این زمینه داشته باشند.
اما پیشنهاد جدید با هدف سادهتر کردن همین فرایند مطرح شده است. به جای این که برای هر شرکت یک دستور جداگانه تعریف شود، سایت میتواند از یک توکن مشترک در robots.txt استفاده و در نهایت ترجیح خود درباره آموزش هوش مصنوعی را اعلام کند. البته این سازوکار فقط زمانی اثرگذار است که شرکتهای ارائهدهنده هوش مصنوعی از آن پشتیبانی کنند. چرا که درج یک دستور در فایل ربات به تنهایی همه شرکتها را ملزم به رعایت آن نمیکند.
دستور مشترک آموزش هوش مصنوعی در robots.txt چه شکلی است؟
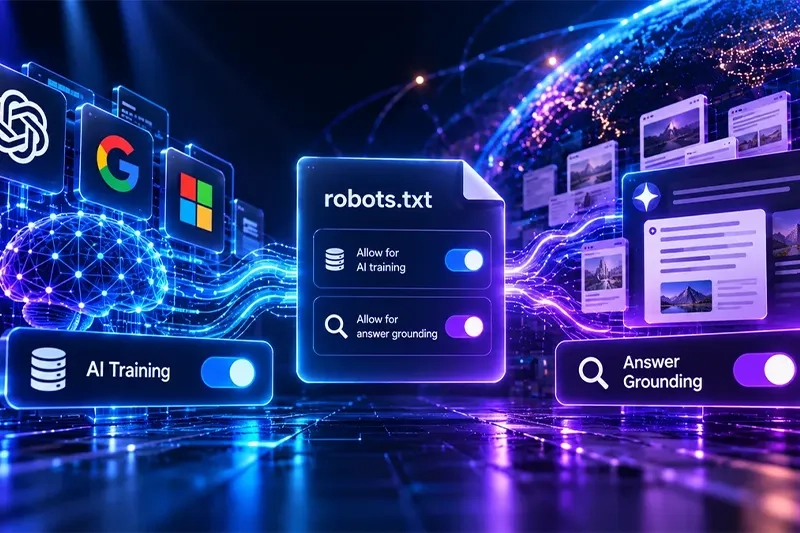
توکن پیشنهادی برای این کنترل __usage_ai-training نام دارد. این عبارت را در خط User-agent قرار میدهیم و سپس با دستورهای Allow و Disallow مشخص میکنیم ترجیح سایت برای هر مسیری چیست. ساختار آن برای سئوکارانی که قبلا با فایل robots.txt کار کردهاند، آشنا بوده و تفاوت اصلی در هدف این گروه است.
برای مثال، فرض کنید مدیر یک سایت تصمیم گرفته است محتوای هیچکدام از صفحاتش برای آموزش مدلهای هوش مصنوعی استفاده نشوند. نمونه زیر در پیشنویس پیشنهادی IETF برای چنین حالتی آمده است:
User-agent: __usage_ai-training


Disallow: /
معنی این دستور ساده است: سایت نمیخواهد محتوای هیچکدام از صفحاتش برای آموزش هوش مصنوعی استفاده شود. علامت / یعنی همه صفحات سایت. البته این دستور جلوی بازدید رباتها از سایت را نمیگیرد، بلکه فقط مشخص میکند که سایت با استفاده از محتوایش برای آموزش هوش مصنوعی موافق نیست.
حالا فرض کنید یک شرکت نرمافزاری میخواهد مقالهها و محتوای آموزشی سایتش برای آموزش مدلها استفاده نشوند، اما اجازه میدهد فایلهای رسانهای و معرفی محصول در مسیر مشخصی از سایت در دسترس این فرایند باشند. نمونه زیر یک استثنا برای مسیر /press-kit/ تعریف میکند:
User-agent: __usage_ai-training


Disallow: /


Allow: /press-kit/
در این مثال، ترجیح کلی سایت مخالفت با آموزش هوش مصنوعی بوده، اما مسیر /press-kit/ از این محدودیت مستثنا شده است. این نمونه بر اساس پیشنویس منتشرشده در IETF است و نباید آن را با یک دستور اجرایی و مورد پشتیبانی همه شرکتها اشتباه گرفت. همچنین Allow به معنی اجبار شرکتها به استفاده از محتوا نیست، فقط ترجیح اعلامشده ناشر را نشان میدهد.
تفاوت دستور جدید robots.txt برای آموزش هوش مصنوعی با Google-Extended چیست؟
Google-Extended یک کنترل اختصاصی گوگل بوده که از سال ۲۰۲۳ در اختیار مدیران سایت قرار گرفته است. این توکن به ناشران اجازه میدهد درباره استفاده از محتوایی که گوگل از سایت دریافت میکند، برای آموزش مدلهای آینده Gemini و برخی کاربردهای مرتبط با Gemini تصمیم بگیرند. در همین ابتدا باید بدانید که این موضوع با دستور جدید robots.txt برای آموزش هوش مصنوعی کاملا فرق میکند. برای مثال، اگر بخواهید استفاده از محتوای سایتتان در این کاربردهای گوگل محدود شود، دستور زیر نمونهای از تنظیم فعلی است:
User-agent: Google-Extended


Disallow: /
این دستور با مسدود کردن Googlebot تفاوت دارد. طبق مستندات گوگل، استفاده از Google-Extended بر حضور سایت در نتایج جستوجوی گوگل اثر نمیگذارد و سیگنال رتبهبندی هم محسوب نمیشود. بنابراین اگر هدف شما حفظ حضور صفحات در گوگل است، نباید این دو دستور را یکی بدانید.
تفاوت مهم دیگر این است که دستور مشترک برای ایجاد یک ترجیح عمومی میان ارائهدهندگان مشارکتکننده طراحی شده است، اما Google-Extended همچنان کنترل اختصاصی گوگل بوده. گوگل اعلام کرده است اگر ناشر از توکن مشترک برای مخالفت با آموزش استفاده کند و در عین حال Google-Extended را صریحا مشخص نکرده باشد، قصد دارد آن را مانند محدودیت Google-Extended تفسیر کند. در مقابل، سایتهایی که به طور مشخص اجازه استفاده از Google-Extended را بدهند، واجد شرایط حضور در پاسخهای Gemini Apps و دریافت کلیک از مسیر grounding خواهند بود.
برای درک بهتر، فرض کنید یک سایت میخواهد به صورت عمومی با آموزش هوش مصنوعی مخالفت کند، اما برای گوگل استثنا قائل شود. نمونه زیر منطق چنین انتخابی را نشان میدهد:
User-agent: __usage_ai-training


Disallow


User-agent: Google-Extended


Allow: /
در این حالت، سایت ترجیح عمومی خود را با توکن مشترک اعلام میکند و برای گوگل یک دستور اختصاصی جداگانه مینویسد. این مثال برای فهم رابطه دو کنترل است. قبل از استفاده عملی باید مستندات جدید گوگل و وضعیت پشتیبانی ارائهدهندگان دیگر بررسی شود.
آیا این تغییر روی سئو و حضور در گوگل دیسکاور اثر میگذارد؟
مهمترین نکته برای سئوکاران این است که نباید کنترل آموزش هوش مصنوعی را با کنترل ایندکس و رتبهبندی اشتباه بگیرند. توکن __usage_ai-training برای اعلام ترجیح درباره استفاده از محتوا در آموزش مدلهای هوش مصنوعی طراحی شده است، نه برای حذف صفحات از نتایج جستوجو. بنابراین اضافه کردن آن به دستور جدید robots.txt برای آموزش هوش مصنوعی به معنی کاهش یا افزایش مستقیم رتبه صفحات نیست.
برای مثال، اگر مقالهای درباره آموزش سئو در سایت منتشر کردهاید و میخواهید همچنان در گوگل جستوجو و دیسکاور قابل مشاهده باشد، نباید صرفا به دلیل مخالفت با آموزش هوش مصنوعی، دسترسی Googlebot را مسدود کنید. گوگل اعلام کرده است Google-Extended بر حضور سایت در Search اثر ندارد. در مقابل، قوانین مربوط به Googlebot بر خزش و محصولات جستوجوی گوگل، از جمله Discover، اثر میگذارند.
اگر کسبوکار شما در همدان فعالیت میکند استفاده از اصول سئو در همدان میتواند به بهبود حضور آنلاین و دیده شدن خدمات شما در جستوجوها و سرچهای مردم شهرتان بسیار تاثیرگذار باشد.
پس اگر هدف شما مدیریت حضور سایت در دیسکاور است، باید تنظیمات مربوط به خزش و دسترسی Googlebot را جداگانه بررسی کنید. تغییر توکن دستور جدید robots.txt برای آموزش هوش مصنوعی جایگزین بررسی کیفیت محتوا، تجربه صفحه، تصاویر مناسب و سایر الزامات حضور در دیسکاور نیست.
سئوکارها قبل از تغییر robots.txt چه کار کنند؟
در حال حاضر بهترین کار، بازبینی فایل موجود و مشخص کردن سیاست سایت درباره استفاده از محتوا در آموزش هوش مصنوعی است. قبل از هر تغییری، نسخه فعلی robots.txt را ذخیره کنید و گروههای مربوط به Googlebot، Google-Extended و User-agent: * را از هم تشخیص دهید. حذف یا جابهجایی اشتباه این گروهها ممکن است دسترسی رباتها به بخشهایی از سایت را تغییر دهد.
برای مثال، اگر در فایل فعلی چنین قانونی دارید:
User-agent: Googlebot


Disallow: /private/
این دستور مسیر /private/ را برای Googlebot محدود میکند و با ترجیح مربوط به آموزش هوش مصنوعی ارتباط مستقیمی ندارد. اضافه کردن توکن جدید نباید باعث شود این قانون قدیمی را حذف کنید یا تصور کنید دیگر نیازی به آن ندارید. هر گروه در robots.txt باید با هدف مشخص خودش تنظیم شود.
نکته مهم این است که پیشنویس IETF هنوز یک استاندارد نهایی و RFC منتشرشده نیست و گوگل نیز پشتیبانی از سازوکار مشترک را برای سال ۲۰۲۷ هدفگذاری کرده است. بنابراین فعلا نمونههای بالا را برای شناخت ساختار و آمادهسازی سیاست سایت بررسی کنید، نه این که بدون بررسی وضعیت اجرایی آنها را به فایل اصلی سایت اضافه کنید. سپس بعد از اعلام پشتیبانی رسمی، تنظیمات را بر اساس مستندات همان ارائهدهنده و نیاز واقعی کسبوکارتان انجام دهید.
آنچه در این محتوا گفتیم
در این محتوا دستور جدید robots.txt برای آموزش هوش مصنوعی را بررسی کردیم و به تمامی جوانب آن پرداختیم. تغییر پیشنهادی گوگل و IETF میتواند مدیریت ترجیحات ناشران درباره آموزش هوش مصنوعی را سادهتر کند، اما برای سئوکاران، مهمتر از حفظ کردن یک دستور جدید، شناخت تفاوت میان سه مفهوم اساسی است. یعنی خزش رباتها، حضور در نتایج جستوجو و استفاده از محتوا برای آموزش مدلهای هوش مصنوعی. اگر این سه موضوع را از هم جدا کنید، احتمال خطا در تنظیم توکن جدید robots.txt کمتر میشود و میتوانید هنگام اجرایی شدن سازوکار مشترک، تصمیم دقیقتری برای سایت بگیرید.
پرسشهای متداول درباره دستور جدید robots.txt برای آموزش هوش مصنوعی
آیا دستور Disallow در توکن جدید جلوی خزش رباتهای هوش مصنوعی را میگیرد؟
خیر. هدف اصلی این توکن اعلام ترجیح درباره استفاده از محتوا برای آموزش مدلهای هوش مصنوعی است، نه مدیریت مستقیم ترافیک رباتها. اگر میخواهید خزش یک ربات مشخص را محدود کنید، باید قوانین مربوط به توکن اختصاصی همان ربات را بررسی نمایید.
آیا با اضافه کردن این دستور، صفحات سایت از گوگل حذف میشوند؟
خیر. این دستور برای کنترل ترجیح آموزش هوش مصنوعی طراحی شده است و جایگزین دستورهای مربوط به خزش و ایندکس گوگل نمیشود. به خصوص نباید آن را با Disallow در گروه Googlebot اشتباه گرفت.
آیا همین حالا باید __usage_ai-training را به robots.txt اضافه کنیم؟
هنوز پشتیبانی فراگیر از این سازوکار آغاز نشده است. گوگل هدفگذاری خود را برای سال ۲۰۲۷ اعلام کرده و پیشنویس آن نیز در مرحله بررسی است. بنابراین پیشنهاد میکنیم قبل از تغییر فایل اصلی، اطلاعیههای رسمی و وضعیت پشتیبانی شرکتهای موردنظر را دنبال کنید.
منبع: